
德国意大利团队实现托卡马克湍流模拟程序加速
 扫码分享
近日,德国马克斯·普朗克等离子体物理研究所(Max Planck Institute for Plasma Physics, 简称 IPP)与意大利米兰理工大学的研究人员联合公开一项聚变模拟研究成果,成功将传统的 TRIMEG-C1 程序重构为 TRIMEG++,并首次将主要计算环节全面迁移至图形处理器(GPU)运行,为扩大托卡马克装置的数值模拟规模提供了高效的软件实现方案。
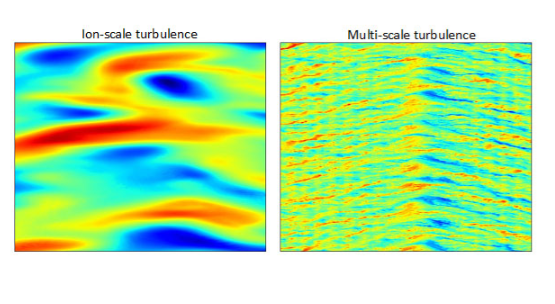
托卡马克湍流模拟需要实时追踪并更新海量计算粒子的运动状态,通过将粒子信息精准投影至网格并求解复杂的电磁场方程,使得计算开销随模拟规模的扩大呈非线性上升。为此,研究团队采用 OpenMP 指令成功实现计算负载迁移,并依托 PETSc 软件库的图形处理器后端处理场方程,使得粒子推进、粒子投影与场求解等核心高强度计算环节得以在加速设备上高效并行。
在 TCV-X21 基准算例的性能测试中,研究人员以配备两颗处理器、合计 256 个计算核心的传统节点作为性能比较基线。测试表明,配备两颗 AMD MI300A 的节点实现了整套模拟 4.1 倍至 6.1 倍的显著加速,而配备四颗 NVIDIA A100 的节点则实现了 2.1 倍至 3.0 倍的加速。测试同时揭示,随着计算粒子数量的不断增加,硬件加速效果更加明显,不同硬件架构的内存布局与数据传输方式对程序的整体表现具有重要影响。
在确保计算性能大幅跃升的同时,研究团队深入比对了不同计算平台的输出结果,严格验证了程序迁移后的数值一致性,并在包含和不包含开放磁力线区域的复杂算例中测试了等离子体不稳定性演化。该项研究将卓越的计算性能测试与严谨的物理量验证有机结合,为未来超大规模聚变装置的虚拟设计与物理实验预测奠定了关键的计算软件基础。
免责声明:本网转载自合作媒体、机构或其他网站的信息,登载此文出于传递更多信息之目的,并不意味着赞同其观点或证实其内容的真实性。本网所有信息仅供参考,不做交易和服务的根据。本网内容如有侵权或其它问题请及时告之,本网将及时修改或删除。凡以任何方式登录本网站或直接、间接使用本网站资料者,视为自愿接受本网站声明的约束。